1Was ist ein API Gateway?
Ein API Gateway ist eine dedizierte Zwischenschicht, die zwischen dem React-Frontend (SPA) und den eigentlichen Backend-Diensten – z. B. mehreren Spring-Boot-Microservices – sitzt und den gesamten eingehenden Traffic bündelt. Statt dass das SPA direkt mit einem oder mehreren Spring-Services spricht, geht jeder Request zuerst durch das Gateway, das entscheidet, wohin er weitergeleitet wird.
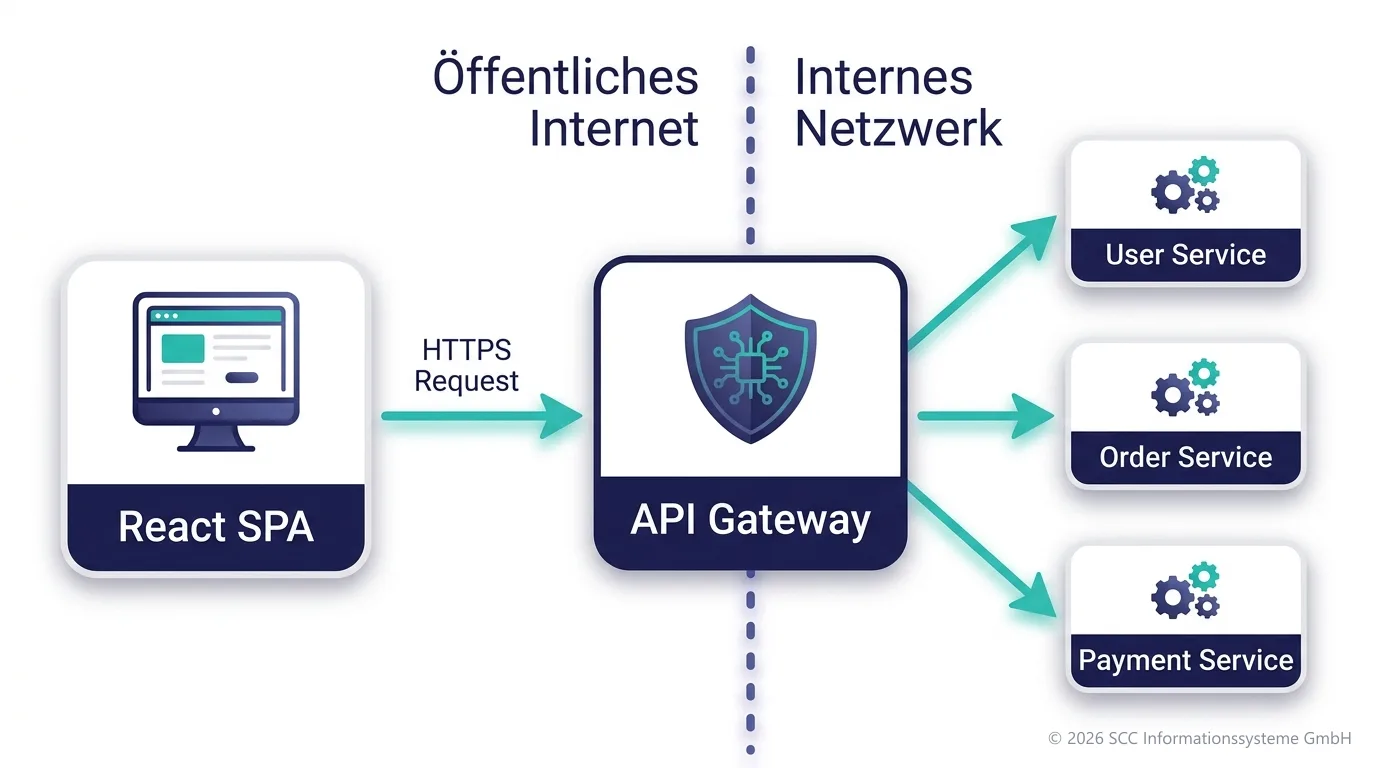
Die Entkopplung hat zwei Seiten:
Strukturell: Das Frontend kennt nur eine stabile URL/Domain, unabhängig davon, wie viele Microservices im Hintergrund existieren, wie sie skaliert, umbenannt, versioniert oder neu deployt werden. Das Backend kann sich frei weiterentwickeln, ohne dass das Frontend angepasst werden muss.
Sicherheitstechnisch: Das Gateway ist die einzige öffentlich erreichbare Komponente, während die Backend-Services in einem internen Netz liegen und nie direkt vom Client aus erreichbar sind.
2Was sollte ein API Gateway abdecken?
- Routing & Komposition — Requests anhand von Pfad, Host oder Header an den richtigen Service weiterleiten; ggf. mehrere Backend-Calls zu einer Antwort aggregieren.
- Security / AuthN / AuthZ — zentrale Token-Validierung (JWT, OAuth2/OIDC), TLS-Terminierung, interne Details nach außen verstecken.
- CORS-Handling — zentrale CORS-Konfiguration, statt dass jeder Microservice das separat regelt.
- Rate Limiting / Throttling — Schutz der Backend-Dienste vor Überlastung oder Missbrauch.
- Request/Response-Transformation — Header anreichern/entfernen, Payloads umformen, API-Versionierung (v1/v2) abbilden.
- Logging, Monitoring, Tracing — Access-Logs, Metriken und Correlation-IDs für Distributed Tracing zentral erfassen.
- Resilience-Patterns — Circuit Breaker, Retries, Timeouts, Fallbacks, damit ein ausfallender Microservice nicht das Gesamtsystem lahmlegt.
- Caching — selten wechselnde Antworten zwischenspeichern, um Last von den Backend-Services zu nehmen.
Im Spring-Umfeld wird dafür meist Spring Cloud Gateway eingesetzt (reaktiv, auf Basis von Spring WebFlux). Alternativen: Kong, NGINX, Traefik oder Cloud-native Angebote wie AWS API Gateway / Azure API Management.
3Spring Cloud Gateway im Detail
Konkrete Einordnung, weil unser eigenes Gateway in TypeScript gebaut wurde — hier die wichtigsten Fakten zu Spring Cloud Gateway als Vergleich.
Sprache: Framework vs. eigener Code
Spring Cloud Gateway als Framework/Library ist selbst in Java geschrieben. Der eigene Anwendungscode darüber — Routen, Filter, Security-Konfiguration — kann aber in Java oder Kotlin geschrieben werden. Beide sind JVM-Sprachen, kompilieren zu Bytecode und sind vollständig interoperabel. Kotlin hat seit Spring Framework 5 first-class Unterstützung (eigene Routing-DSL, Null-Safety-Interop, Coroutines als Alternative zu Reactor-Ketten in WebFlux) und wird bei neuen Spring-Projekten häufig bevorzugt.
Blockierend vs. nicht-blockierend
Der Unterschied betrifft das Nebenläufigkeitsmodell: im klassischen (blockierenden) Servlet-Modell hält jeder gleichzeitige Request einen eigenen Thread belegt, auch während der Thread nur auf eine Antwort von einem Backend-Service oder einer Datenbank wartet — bei vielen parallelen, langlaufenden Requests wird das schnell zum Skalierungsproblem (Thread-Pool erschöpft). Im nicht-blockierenden Modell von WebFlux/Netty gibt ein Thread die Kontrolle frei, während er auf I/O wartet, und kann in der Zwischenzeit andere Requests bearbeiten — ein kleiner Thread-Pool reicht damit für sehr viele gleichzeitige, meist I/O-wartende Verbindungen. Für ein Gateway, dessen Hauptaufgabe darin besteht, Requests entgegenzunehmen und auf die Antwort von Backend-Services zu warten, ist das genau das passende Modell.
Der wichtige Punkt für den Vergleich mit unserem TypeScript-Gateway: dieses Modell ist vom Grundprinzip näher an Node.js, als man auf den ersten Blick denkt — beide sind nicht-blockierend und event-loop-basiert, nur eben auf unterschiedlichen Runtimes (JVM mit Netty/Reactor vs. V8 mit dem Node-Event-Loop). Der oft gehörte Vergleich „Java ist blockierend/langsamer, Node ist nicht-blockierend/schneller“ greift hier also nicht — Spring Cloud Gateway wurde bewusst auf dieser nicht-blockierenden Basis gebaut, gerade weil klassisches Spring MVC (Tomcat, blockierend) für einen Gateway-Anwendungsfall ungeeignet wäre.
Deployment
Spring Cloud Gateway läuft als eigenständiges Spring-Boot-Jar in einem eigenen Docker-Image/Container — komplett getrennt von den Backend-Service-Containern. Nur der Gateway-Container ist nach außen exponiert; die Backend-Container haben keinen öffentlichen Port und sind nur über das interne Container-Netzwerk (Service-Namen) erreichbar. Jedes Image wird unabhängig gebaut, versioniert und deployed.
Vergleich mit einem selbstgebauten TypeScript-Gateway
| Aspekt | Spring Cloud Gateway | Eigenes TS-Gateway (Express/Fastify/NestJS) |
|---|---|---|
| Sprache/Runtime | Java oder Kotlin auf der JVM | TypeScript auf Node.js |
| Nebenläufigkeit | Reaktiv, nicht-blockierend (WebFlux/Netty) | Nicht-blockierend, Event-Loop (V8) |
| Security (JWT/OIDC) | Weitgehend vorgefertigt (Spring Security OAuth2 Client/Resource Server) | Selbst integriert (z. B. jose/jsonwebtoken + eigener JWKS-Abruf) |
| Rate Limiting / Circuit Breaker | Fertige Filter (Resilience4j-Integration) | Selbst integriert (z. B. express-rate-limit, opossum) |
| Konfigurationsstil | Predicates/Filters, meist YAML — Konfiguration statt Code | Middleware-Code, explizite Kontrolle |
| Stack-Konsistenz zum Backend | Gleich, wenn Backend-Services auch Spring Boot sind | Zwei Stacks (TS-Gateway + Java-Backend), falls Backend Spring Boot ist |
| Deployment | Eigenes Docker-Image/Container | Ebenso eigenes Docker-Image/Container |
Kurz: Spring Cloud Gateway ist „batteries included“ und konfigurationsgetrieben, ein selbstgebautes TS-Gateway gibt mehr explizite Kontrolle, erfordert aber mehr Eigenintegration der einzelnen Bausteine.
4Security-Architektur: wer prüft was?
Die zentrale Frage lautet immer: wer prüft was, und wo liegt das „Vertrauensende“? Grundprinzip: Token-Validierung am Gateway, fachliche Autorisierung im Backend.
| Ebene | Zuständigkeit | Wo? |
|---|---|---|
| AuthN (Authentication) | Wer ist der Nutzer? Ist das Token gültig? | API Gateway |
| AuthZ (Authorization) | Darf dieser Nutzer diese fachliche Aktion ausführen? | Jeweiliger Spring-Service |
Diese Trennung verhindert, dass jeder Microservice eigene Login-Logik pflegen muss – die feingranulare, fachliche Berechtigungsprüfung findet aber trotzdem dort statt, wo die Domänenlogik liegt.
5JWT-Validierung am Gateway
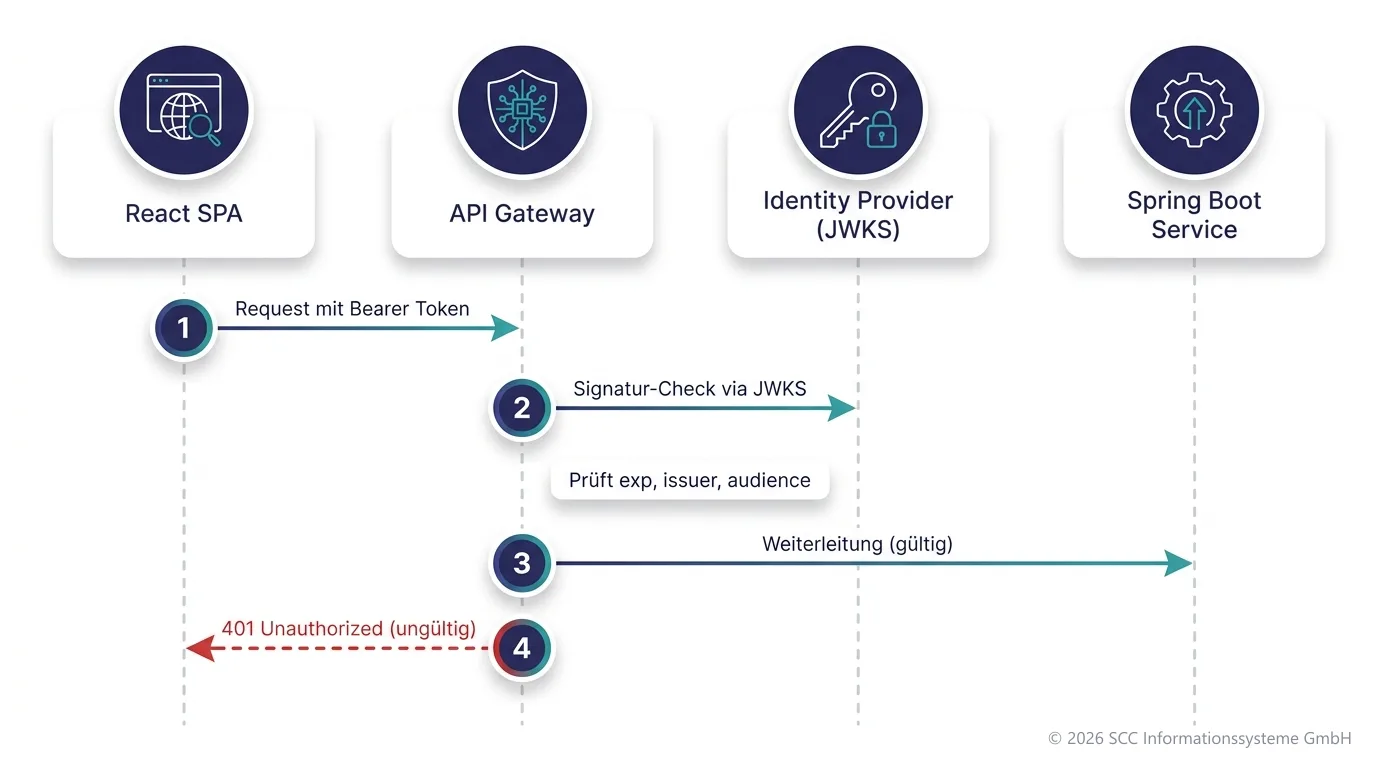
Das SPA schickt bei jedem Request ein JWT Access Token im Authorization-Header (Bearer-Token) mit. Das Gateway validiert dieses Token, bevor der Request überhaupt weitergeleitet wird:
Signatur gegen die öffentlichen Schlüssel des Identity Providers prüfen (JWKS-Endpoint, z. B. von Keycloak, Auth0, Azure AD B2C), Ablaufzeit (exp) prüfen, Issuer und Audience prüfen. Ist das Token ungültig oder abgelaufen, blockt das Gateway den Request direkt mit 401 — der Spring-Service sieht ihn nie.
Wie kommt das Token beim Backend an?
Zwei verbreitete Muster:
| Variante | Beschreibung | Trade-off |
|---|---|---|
| Token-Durchreichung | Original-JWT wird 1:1 an den Service weitergereicht; Spring-Service validiert intern nochmal (z. B. via spring-boot-starter-oauth2-resource-server). | Einfacher, aber das sensible Token durchquert das interne Netz. |
| Claims-Extraktion | Gateway extrahiert User-ID, Rollen, Tenant und reicht sie als eigene interne Header weiter; das Original-Token bleibt am Gateway. | Sicherer, erfordert aber Vertrauen ins interne Netz (mTLS / Service-Mesh gegen Header-Spoofing). |
6Login-Flow aus dem SPA
Der Login läuft direkt zwischen SPA und Identity Provider (IdP), nicht über das Gateway. Standard dafür ist der OAuth2/OIDC Authorization Code Flow mit PKCE — der für SPAs (Public Clients ohne Client Secret) heute Best Practice ist. Der frühere Implicit Flow gilt als veraltet und unsicher.
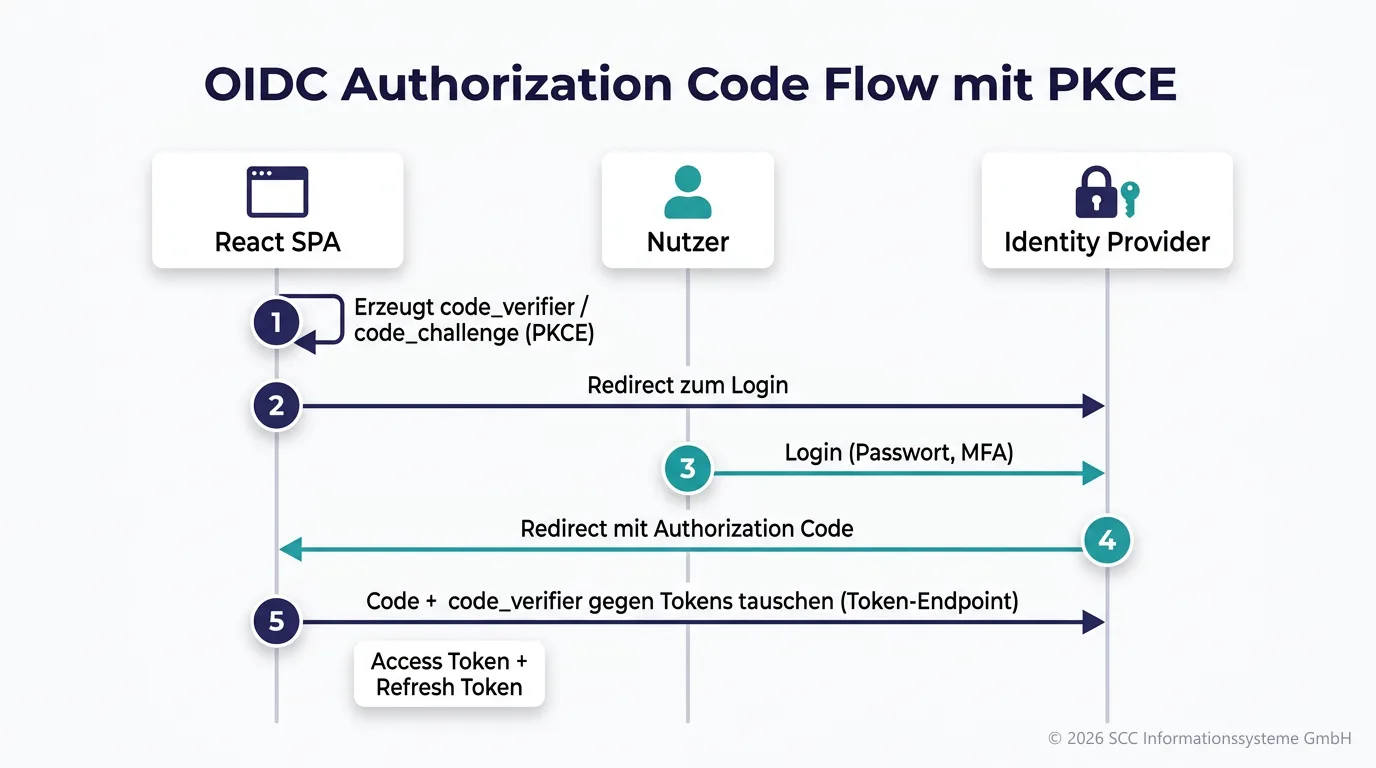
Ablauf im Detail:
1. Das SPA generiert dynamisch ein code_verifier/code_challenge-Paar (PKCE) — das verhindert, dass ein abgefangener Authorization Code von einem Angreifer eingelöst werden kann.
2. Redirect zum IdP (z. B. Keycloak-Login-Seite).
3. Der Nutzer authentifiziert sich (Passwort, ggf. MFA).
4. Der IdP leitet mit einem Authorization Code zurück auf die Redirect-URI der SPA.
5. Das SPA tauscht Code + code_verifier gegen Access Token und Refresh Token am Token-Endpoint des IdP.
7Token-Speicherung & das BFF-Pattern
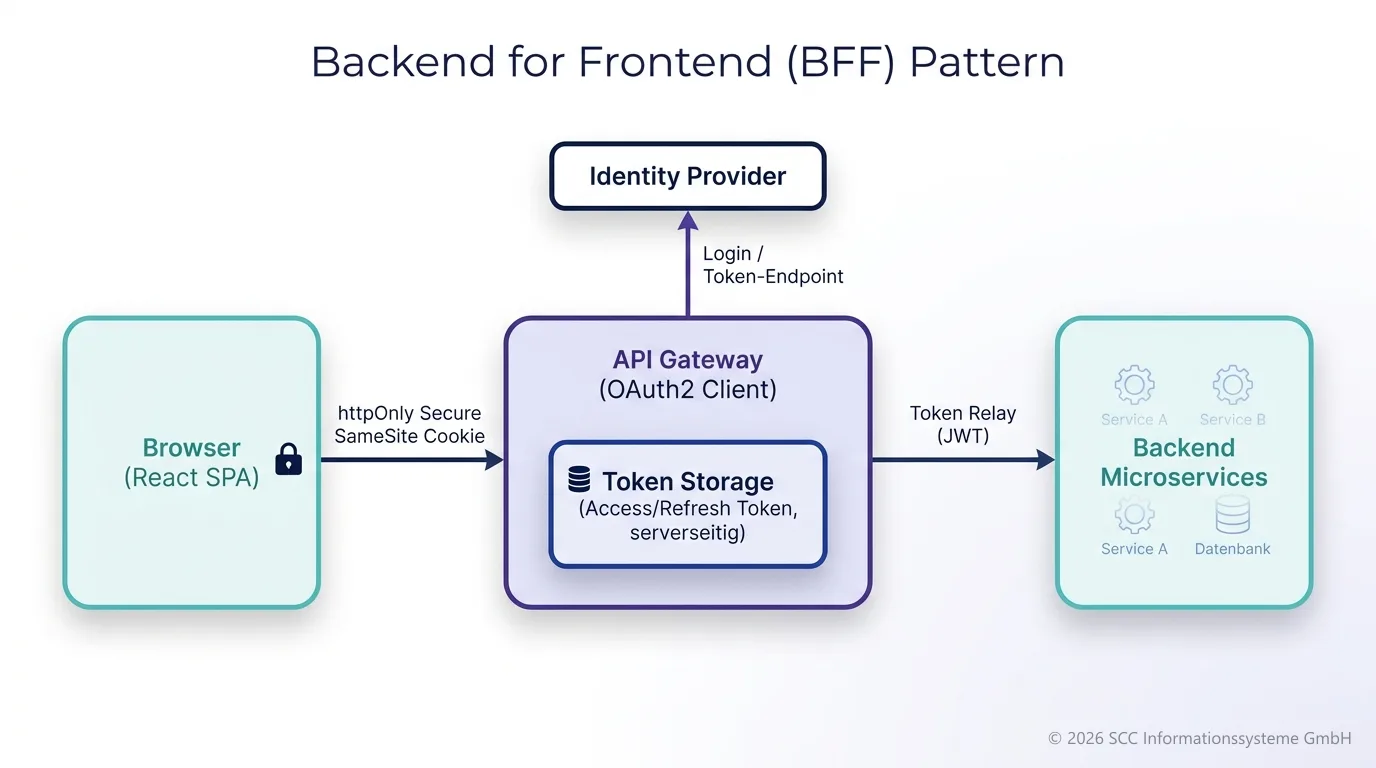
Die kritische Frage danach: wo speichert das SPA die Tokens? Das ist der heikelste Punkt bei SPA-Security.
localStorage oder sessionStorage sind anfällig für XSS — ein eingeschleustes Skript kann Tokens auslesen und exfiltrieren.Der heute empfohlene Ansatz ist meist BFF-artig (Backend for Frontend): Das Gateway übernimmt selbst die Rolle des OAuth2-Clients (z. B. Spring Cloud Gateway mit TokenRelay-Filter bzw. spring-boot-starter-oauth2-client), hält die Tokens serverseitig und gibt dem Browser nur ein httpOnly, Secure, SameSite-Cookie als Session-Referenz. Das SPA hat damit im JavaScript-Kontext nie direkten Zugriff auf das JWT — das XSS-Risiko sinkt deutlich.
Alternative: Tokens direkt im SPA
Verbreitet ist auch, Tokens direkt im SPA zu verwalten (z. B. mit oidc-client-ts) und nur in Memory zu halten (nicht localStorage), inkl. Silent-Refresh via Refresh Token Rotation. Das gilt als etwas riskanter und erfordert mehr Sorgfalt bei der Content-Security-Policy, um XSS von vornherein zu minimieren.
8BFF-Pattern: Code-Beispiel mit Spring Cloud Gateway
Minimales, aber vollständiges Beispiel für Abschnitt 7: das Gateway übernimmt selbst die Rolle des OAuth2-Clients gegenüber Keycloak (oder einem anderen IdP) — das SPA sieht davon praktisch nichts außer einem Cookie.
1. Dependencies
pom.xml<dependency>
<groupId>org.springframework.cloud</groupId>
<artifactId>spring-cloud-starter-gateway</artifactId>
</dependency>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-oauth2-client</artifactId>
</dependency>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-security</artifactId>
</dependency>2. OAuth2-Client-Registrierung + Route mit TokenRelay
application.ymlspring:
security:
oauth2:
client:
registration:
keycloak:
client-id: spa-gateway-client
client-secret: ${KEYCLOAK_CLIENT_SECRET}
authorization-grant-type: authorization_code
redirect-uri: "{baseUrl}/login/oauth2/code/keycloak"
scope: openid, profile, email
provider:
keycloak:
issuer-uri: https://idp.example.com/realms/myrealm
cloud:
gateway:
routes:
- id: order-service
uri: http://order-service:8080
predicates:
- Path=/api/orders/**
filters:
- TokenRelay=
server:
reactive:
session:
cookie:
same-site: Lax
http-only: true
secure: trueDer Filter TokenRelay= ist der eigentliche Trick: er nimmt das Access Token, das Spring Security im Rahmen des OAuth2-Logins serverseitig für den Nutzer gespeichert hat, und hängt es automatisch als Authorization: Bearer …-Header an den Request zum Backend — ohne dass das Token je den Browser erreicht.
3. Security-Konfiguration (reaktiv, WebFlux)
SecurityConfig.java@Configuration
@EnableWebFluxSecurity
public class SecurityConfig {
@Bean
SecurityWebFilterChain springSecurityFilterChain(ServerHttpSecurity http) {
http
.authorizeExchange(exchanges -> exchanges
.pathMatchers("/login/**", "/oauth2/**").permitAll()
.anyExchange().authenticated())
.oauth2Login(Customizer.withDefaults())
.logout(Customizer.withDefaults());
return http.build();
}
}oauth2Login() bringt automatisch die nötigen Endpunkte mit — u. a. /oauth2/authorization/keycloak, das den Redirect zum Login auslöst.
4. Was die SPA davon sieht
Nichts von OIDC/PKCE — kein oidc-client-ts, kein Token-Handling im Frontend. Ist der Nutzer nicht eingeloggt, leitet das Gateway automatisch zum Login um; danach reicht ein normaler fetch mit Cookie:
fetch('/api/orders', { credentials: 'include' })Das Cookie (Session-ID) wird automatisch mitgeschickt, das Gateway löst daraus serverseitig das gespeicherte Access Token auf und hängt es für den Backend-Call an.
spring-session-data-redis), damit jede Gateway-Instanz auf dieselben Sessions zugreifen kann.9CSRF-Schutz beim Cookie-basierten Ansatz
Wichtiger Punkt zuerst, weil er oft missverstanden wird: httpOnly schützt vor XSS, aber nicht vor CSRF. httpOnly verhindert nur, dass JavaScript den Cookie-Wert auslesen kann. Der Browser hängt das Cookie trotzdem automatisch an jeden Request an die Gateway-Domain an — unabhängig davon, welche Seite den Request ausgelöst hat. Genau das ist die CSRF-Lücke: eine bösartige Seite (evil.example) kann im Hintergrund ein Formular oder einen fetch-Request gegen euer Gateway absenden, und der Browser schickt das gültige Session-Cookie automatisch mit — ohne dass die bösartige Seite den Cookie-Wert je gesehen hat.
| Schutzmechanismus | Schützt vor | Reicht alleine? |
|---|---|---|
httpOnly | Auslesen des Cookies per JavaScript (XSS) | Nein — kein CSRF-Schutz |
SameSite=Lax/Strict | Automatisches Mitschicken des Cookies bei den meisten Cross-Site-Requests | Erste Verteidigungslinie, aber nicht 100 % (Edge-Cases, Subdomains, ältere Browser) |
| CSRF-Token (Double-Submit) | Gefälschte state-verändernde Requests (POST/PUT/DELETE) | Ja, als Defense-in-Depth zusätzlich zu SameSite |
SameSite als erste Verteidigungslinie
Im Beispiel aus Abschnitt 8 stand bereits same-site: Lax in der Konfiguration. Lax sorgt dafür, dass das Cookie bei Cross-Site-POST/fetch/XHR-Requests nicht mitgeschickt wird, wohl aber bei normaler Top-Level-Navigation (z. B. ein Link aus einer E-Mail). Strict blockt zusätzlich auch das — für eine reine API/SPA-Anwendung ohne klassische Server-Side-Navigation oft die sicherere und ebenso praktikable Wahl.
CSRF-Token als Defense-in-Depth
Weil man sich nicht allein auf ein einzelnes Browser-Feature verlassen möchte, ergänzt man klassisch einen expliziten CSRF-Token-Check für alle state-verändernden Methoden (POST, PUT, DELETE, PATCH) — GET/HEAD/OPTIONS gelten als „sicher“ (seiteneffektfrei) und werden ausgenommen. Spring Security bringt dafür im WebFlux-Stack das Cookie-to-Header-Pattern (Double-Submit-Cookie) fertig mit: der Server setzt einen zusätzlichen, bewusst nicht httpOnly gesetzten Cookie namens XSRF-TOKEN mit einem zufälligen Token-Wert. Das Frontend liest diesen Cookie-Wert per JavaScript aus und schickt ihn bei jedem state-verändernden Request zusätzlich als Header X-XSRF-TOKEN zurück. Der Server vergleicht Header- und Cookie-Wert — eine fremde Seite kann diesen Header nicht setzen, weil sie den Cookie-Wert (anders als das Opfer selbst) nicht per JavaScript auslesen kann (Same-Origin-Policy).
@Bean
SecurityWebFilterChain springSecurityFilterChain(ServerHttpSecurity http) {
    http
        .authorizeExchange(exchanges -> exchanges
            .pathMatchers("/login/**", "/oauth2/**").permitAll()
            .anyExchange().authenticated())
        .oauth2Login(Customizer.withDefaults())
        .csrf(csrf -> csrf
            .csrfTokenRepository(CookieServerCsrfTokenRepository.withHttpOnlyFalse()))
        .logout(Customizer.withDefaults());
    return http.build();
}CsrfToken-Attribut abonniert — sonst wird der XSRF-TOKEN-Cookie nie in die Response geschrieben, selbst wenn die Konfiguration korrekt ist. Übliche Lösung: ein kleiner zusätzlicher WebFilter, der das CsrfToken-Attribut aus dem Exchange holt und subscribed, damit der Cookie bei jedem Request gesetzt/erneuert wird.Beispiel auf Seiten des SPA
Da React (anders als Angular) kein automatisches XSRF-Cookie-Handling mitbringt, liest man den Cookie-Wert manuell aus und hängt ihn an den Header:
function getCookie(name) {
  const match = document.cookie.match(new RegExp('(^| )' + name + '=([^;]+)'));
  return match ? decodeURIComponent(match[2]) : null;
}

fetch('/api/orders', {
  method: 'POST',
  credentials: 'include',
  headers: {
    'Content-Type': 'application/json',
    'X-XSRF-TOKEN': getCookie('XSRF-TOKEN')
  },
  body: JSON.stringify(payload)
});
Alternative: HTTP-Client-Bibliotheken wie Axios unterstützen dieses Cookie-zu-Header-Pattern teilweise automatisch (Konfiguration über xsrfCookieName/xsrfHeaderName), sodass der manuelle Auslese-Code entfällt.
Marken- und Produktnamen
In diesem Dokument genannte Produkt-, Firmen- und Markennamen — u. a. Spring, Spring Boot, Spring Cloud Gateway, React, Node.js, Keycloak, Auth0, Azure AD B2C, AWS, Kubernetes, Redis, Java, Kotlin, Docker — sind Marken bzw. eingetragene Marken der jeweiligen Rechteinhaber. Sie werden hier ausschließlich zu illustrativen und erklärenden Zwecken verwendet; eine Zugehörigkeit, Empfehlung oder Zusammenarbeit mit den jeweiligen Unternehmen ist damit nicht verbunden.